
Ziel
Aus Lernertexten Muster und einen nächsten Lernschritt ableiten

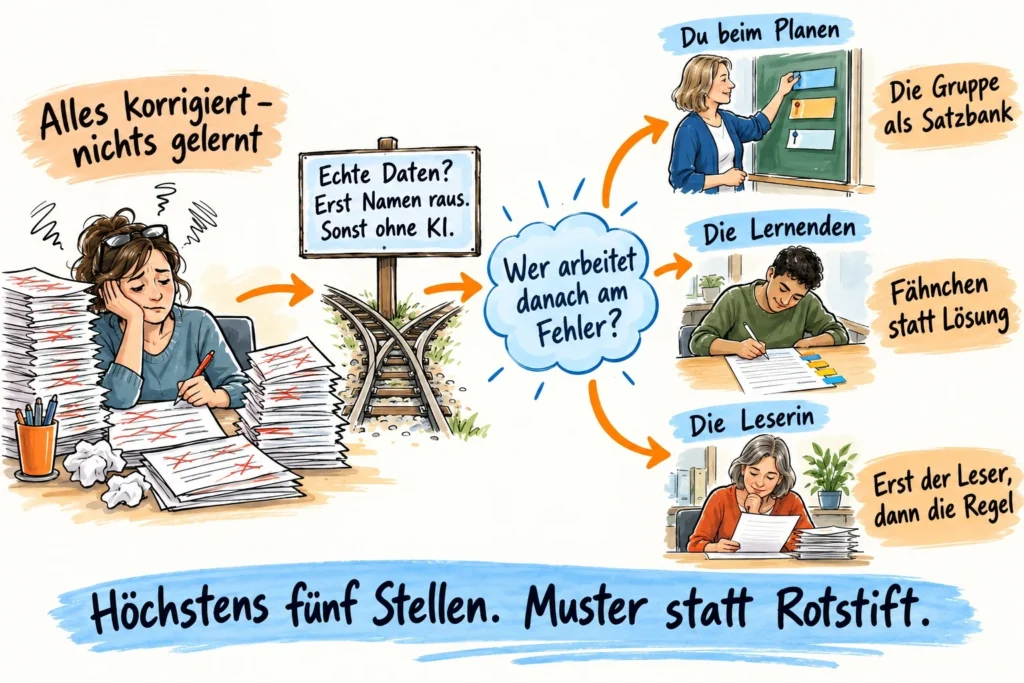
Vierzehn Texte, fünf Minuten, alles korrigiert, mit Erklärung. Eine Woche später steht im nächsten Text derselbe Fehler. Eine Vollkorrektur zeigt, was falsch war, aber nicht, woran die Gruppe jetzt arbeiten soll. Fehleranalyse mit KI wird erst lernwirksam, wenn die KI weniger tut: höchstens fünf Stellen, Muster statt Einzelfehler, Ursachen als Vermutung. Und davor kommt eine Weiche: Echte Daten von Lernenden? Erst Namen und Persönliches raus. Sonst ohne KI.
Warum eine KI-Vollkorrektur im Sprachkurs kaum etwas lehrt – und drei Wege, wie aus Fehlern Muster werden.
Im Integrationskurs (IK) und im Berufssprachkurs (BSK) kommen nach einer Schreibaufgabe schnell fünfzehn Texte zusammen, jeder mit zwanzig oder dreißig Abweichungen. Mit KI ist die Korrektur in Minuten erledigt. Das Werkzeug liefert, worum es gebeten wird: eine saubere Fassung, jede Stelle erklärt, oft dazu ein freundlicher Absatz über Stärken. Für Deutsch als Fremd- bzw. Zweitsprache (DaF/DaZ) ist das ein bekanntes Problem in neuer Geschwindigkeit. Eine Korrektur, die alles zeigt, zeigt keine Richtung. Die Lernenden sehen viel Rot, lesen die neue Fassung einmal und schreiben beim nächsten Mal wie vorher.
Die naheliegende Erklärung lautet: Die KI korrigiert schlecht. Meist korrigiert sie aber eher zu viel als zu schlecht. Sie hat keinen Auftrag, auszuwählen, und sie weiß nicht, was gerade Lernziel ist. Drei weitere Ursachen kommen dazu. Viele Lernende erwarten eine Vollkorrektur, weil sie es aus der Schule so kennen, und lesen alles andere als Nachlässigkeit. Unter Zeitdruck wird die KI-Fassung schnell zur Musterlösung, die zurück in den Kurs wandert. Und eine Erklärung wie „falscher Kasus nach Wechselpräposition“ ist richtig, sagt einer Lernenden auf A2 aber nichts.
Dazu kommt etwas, das im IK besonders schwer wiegt. Lernertexte erzählen oft mehr, als in ein KI-Werkzeug gehört: der Termin bei der Ausländerbehörde, die Krankheit des Kindes, der Name der Vermieterin. Wer ganze Texte hochlädt, gibt diese Angaben mit.
Nicht jedes Problem löst eine bessere Auswertung. Hat jemand die Aufgabe nicht verstanden, etwa einer Freundin geschrieben statt der Hausverwaltung, ist das kein Fehlermuster, sondern Aufgabenarbeit. Und ein Text, der auf A1 aus einzelnen Wörtern besteht, braucht Satzbausteine, keine Analyse.
Welche Auswertung du brauchst, hängt davon ab, wer danach am Fehler arbeitet: du beim Planen, die Lernenden beim Überarbeiten oder die Person, die den Text am Ende liest. Für jede dieser drei gibt es einen eigenen Weg.
Die Gruppe als Satzbank: Hier arbeitet die KI für dich und nicht für einzelne Lernende. Statt fünfzehn Texte hochzuladen, tippst du aus jedem Text zwei oder drei Sätze ab, nummerierst sie und lässt Namen, Orte und alles Persönliche weg. So entsteht eine Satzbank mit dreißig bis vierzig Sätzen, die niemandem mehr gehört. Der Auftrag an die KI ist eng: „Finde in diesen Sätzen höchstens drei Fehlermuster, die in mindestens vier Sätzen vorkommen. Nenne zu jedem Muster die Satznummern und eine mögliche Ursache als Vermutung. Schreibe keine korrigierte Fassung.“ Danach prüfst du jedes Muster an zwei Sätzen selbst, denn KI findet auch Muster, die keine sind. Im Kurs folgt eine Musterstunde von zwanzig Minuten: Drei Sätze aus der Satzbank stehen an der Tafel, ohne Namen. Die Ansage: „Diese drei Sätze kommen aus unserem Kurs. Sie sind nicht falsch, weil jemand schlecht ist, sondern weil das Deutsche hier eine Falle stellt. Was ist bei allen drei gleich?“ Erst wenn die Gruppe das Muster benennt, kommt die Regel, und danach schreibt jede Person zwei eigene Sätze mit genau dieser Struktur. Ihre Stärke zeigt die Satzbank, wenn viele ähnliche Fehler machen und die nächste Stunde ansteht. Sind die Fehler sehr verschieden oder braucht jemand eine Rückmeldung zum eigenen Text, findet sie nichts Gemeinsames.
Fähnchen statt Lösung: Hier arbeitet die KI für die Lernenden, aber sie verrät nichts. Aus einem anonymisierten Text lässt du höchstens fünf Stellen auswählen, und zu jeder Stelle gibt es drei Hinweisstufen: einen Suchhinweis („In Zeile 3 stimmt etwas mit dem Verb nicht“), einen Regel- oder Bedeutungsimpuls („Nach weil steht das Verb am Ende“) und zuletzt eine Entscheidung zwischen zwei Formen. Im Auftrag an die KI stehen dafür drei Dinge: das Lernziel der Stunde, die Grenze von fünf Stellen und das Verbot, die richtige Form zu nennen. Die Lernenden bekommen ihren Text mit fünf Klebezetteln am Rand zurück, die Stufen zum Aufklappen. Die Ansage: „Sie bekommen heute keine Korrektur, Sie bekommen fünf Fähnchen. Lesen Sie zuerst nur Stufe 1. Erst wenn Sie nach zwei Minuten nichts finden, nehmen Sie Stufe 2.“ Ein kleiner Kniff macht daraus auch für dich eine Auswertung: Was die Person selbst gefunden hat, schreibt sie in Grün, was erst mit Hinweis kam, in Blau. Viel Grün zeigt dir, dass die Person die Regel kennt und unter Druck nicht anwendet. Viel Blau zeigt eine echte Wissenslücke. Fähnchen brauchen eine Struktur, die die Gruppe schon einmal hatte; bei ganz Neuem führen sie ins Raten. Am meisten bringen sie bei der zweiten Fassung eines Textes.
Erst der Leser, dann die Regel: Hier arbeitet die KI für die Person, die den Text am Ende liest. Gerade im BSK und im Alltag mit Ämtern zählt zuerst, ob ein Text ankommt. Du nennst der KI den Empfänger, etwa „Sachbearbeiterin im Jobcenter“ oder „Pflegedienstleitung bei der Übergabe“, und lässt die Stellen in drei Gruppen sortieren: stört das Verstehen nicht, irritiert kurz, gefährdet das Verstehen. Korrigiert wird nur die dritte Gruppe, vielleicht noch eine Stelle aus der zweiten. Dazu kommt eine Leseprobe im Kurs. Die Ansage an das Paar: „Lesen Sie den Text so vor, wie ihn die Hausverwaltung liest. Wo Sie stocken, machen Sie einen Strich an den Rand. Nicht korrigieren, nur stocken.“ Danach liegen die Striche neben der Einteilung der KI. Wo beide übereinstimmen, wird überarbeitet. Wo nur die KI etwas rot sieht, lohnt die Frage: Würde die Sachbearbeiterin das überhaupt bemerken? Dieser Weg trägt bei Texten, die wirklich verschickt werden, und bei Gruppen, die von zu viel Rot entmutigt sind. In der Prüfungsvorbereitung reicht er allein nicht, denn dort zählt auch Richtigkeit, die niemanden stört.
Stell dir einen BSK mit Schwerpunkt Pflege vor, zwölf Lernende auf B1, Aufgabe: ein kurzer Übergabebericht. In den Texten stehen Namen von Bewohnerinnen und Bewohnern, Zimmernummern, Medikamente. Infrage kommen die Satzbank und die Fähnchen. Die erste Durchsicht zeigt, dass neun von zwölf nach „dann“ oder „danach“ das Verb ans Satzende stellen. Ein Muster, viele Lernende: Das spricht für die Satzbank. Du tippst je zwei Sätze ab, ersetzt jeden Namen durch [Bewohnerin], lässt Medikamente weg und lässt die KI nur nach diesem einen Muster suchen. In der Musterstunde stehen drei Sätze an der Tafel. Die Ansage: „Das sind Sätze aus unseren Berichten. Was macht das Verb nach ‚danach‘?“ Fähnchen gibt es in der Woche darauf, für den zweiten Bericht.
Anders ein IK im Modul 5, Lernende auf A2 bis B1. Eine Teilnehmerin hat eine E-Mail an ihre Vermieterin geschrieben, es geht um Schimmel im Bad, und sagt: „Bitte alles korrigieren, ich schicke die Mail wirklich.“ Infrage kommen die Fähnchen und der Leser-Weg. Weil die Mail echt ist, entscheidet die Vermieterin, was zählt. Du nimmst Name und Adresse heraus, lässt die KI die Stellen nach Wirkung sortieren, und die Leseprobe mit der Sitznachbarin zeigt zwei Stellen, an denen beide stocken: der Zeitpunkt und die Bitte um einen Termin. Die Ansage: „Diese zwei Stellen entscheiden, ob Ihre Vermieterin kommt. Die machen wir jetzt richtig. Den Rest schauen wir uns nächste Woche an Ihrer Übungsfassung an.“ Die überarbeitete Mail siehst du noch einmal durch, bevor sie rausgeht.
Vor jeder Auswertung steht dieselbe Weiche: Sind echte Daten von Lernenden im Text, kommen zuerst Namen und Persönliches heraus. Geht das nicht, ohne den Text zu zerstören, wird ohne KI ausgewertet. Anonymisieren geht in drei Schritten. Erstens abtippen statt hochladen: nur die Sätze, um die es geht. Zweitens ersetzen: Namen, Orte, Daten, Firmen und Behörden durch Platzhalter wie [Name] oder [Stadt]. Drittens herausnehmen: Aufenthalt, Gesundheit und Familie gehören gar nicht hinein, auch nicht verfremdet. Welches Werkzeug du nutzen darfst, entscheiden die Vorgaben deines Trägers, nicht die Bequemlichkeit. Mehr dazu steht auf der Seite Sensible Daten nicht eingeben.
Zwei Reflexe kosten mehr, als sie bringen. Der erste: Die KI-Fassung als Musterlösung austeilen. Dann vergleichen die Lernenden zwei Texte und schreiben ab, statt eine Form selbst zu finden. Der zweite: Die Ursache, die die KI nennt, als Diagnose übernehmen. Sätze wie „Das ist ein typischer Fehler arabischsprachiger Lernender“ klingen fachkundig. Sie sind eine Vermutung, manchmal ein Klischee, und sie gehören nie in eine Rückmeldung an eine Person. Im Fehlerprotokoll steht deshalb „Vermutung“, nicht „Ursache“.
Bleibt der Wunsch nach Vollkorrektur. Er ist ernst zu nehmen, denn dahinter steht oft Sorge vor der Prüfung oder vor dem Amt. Eine Ansage, die ihn aufnimmt: „Ich zeige Ihnen heute nicht alle Fehler. Ich zeige Ihnen die fünf wichtigsten, und an denen arbeiten Sie selbst. Die anderen kommen später dran.“ Bei Texten, die wirklich verschickt werden, bekommt die Person nach der Überarbeitung zusätzlich deine kurze Durchsicht.
Dass digitale Rückmeldung zum Schreiben in einer Fremdsprache wirken kann, zeigt eine Meta-Analyse über 14 Studien: Computergestützte Korrektur verbesserte Genauigkeit und Flüssigkeit deutlich, bei Anfänger:innen und Mittelstufe stärker als bei Fortgeschrittenen. In einer großen Studie aus Deutschland überarbeiteten Jugendliche im Englischunterricht ihre Texte mit KI-Rückmeldung etwas besser als ohne, und sie waren dabei motivierter. Eine zweite Studie derselben Arbeitsgruppe zeigt die Grenze: Lehramtsstudierende hielten KI-Rückmeldungen nur bei gut der Hälfte der Texte für hilfreich, Rückmeldungen von Fachleuten bei fast neun von zehn. Keine dieser Studien untersucht Erwachsene im IK oder BSK. Sie stützen die Annahme, dass KI-Rückmeldung helfen kann, wenn jemand sie prüft und auswählt. Dass weniger Stellen mehr bringen, ist hier eine didaktische Begründung, kein Studienbefund.
Dieselben fünf Fragen gelten für jede KI-Aufgabe im Sprachunterricht, hier auf die Fehlerarbeit bezogen.
Die KI-Auswertung ist in Minuten fertig, das Auswählen dauert. Welche fünf Stellen zählen, welche Vermutung zur Ursache trägt und was davon morgen im Kurs drankommt, entscheidest du – und genau dort bleibt nach einem vollen Kurstag oft keine Kraft mehr. Das Fehlerprotokoll nimmt dir diese Entscheidung nicht ab, aber es gibt ihr eine feste Form, mit oder ohne KI.
Es hat vier Seiten: ein Deckblatt mit Einsatzhinweis, drei Schritte, mit denen Namen und Persönliches vor dem Hochladen herauskommen, ein Protokoll für höchstens fünf Stellen mit Satz, Muster und Vermutung und eine Zeile für den nächsten Schritt sowie vier Fähnchenkarten als Kopiervorlage, mit denen die Lernenden in drei Stufen selbst korrigieren.
Dieselbe Routine, acht Situationen im Kurs.
Die KI sortiert die Fehler nach Quelle: Aufgabe nicht verstanden, Zeit, Wortschatz, Grammatik. Oft liegt das Problem im Format und nicht in der Sprache.
Du notierst beim Zuhören nur Sätze, keine Namen, und wertest erst danach aus. Korrigiert wird im zweiten Sprechversuch, nicht mitten im Satz.
Kommt derselbe Fehler seit Wochen, hilft keine weitere Regel. Besser sind ein falsches und ein richtiges Beispiel nebeneinander und eine kurze Übung an drei Kurstagen.
Dieselbe Satzbank, unterschiedliche Stufen. Wer sicher ist, bekommt nur den Suchhinweis, wer unsicher ist, gleich die Wahl zwischen zwei Formen.
In Übergaben, Berichten und E-Mails an Vorgesetzte zählt zuerst, ob Zeit, Menge und Auftrag klar sind. Die Grammatik kommt danach.
Die Partnerin sucht nur ein vorher festgelegtes Muster, zum Beispiel das Verb an Position zwei. Alles andere bleibt unkommentiert.
Die Lernenden nehmen ihre Hinweise mit nach Hause, nicht die Lösung. In der nächsten Stunde zeigen sie, was sie selbst gefunden haben.
Du markierst fünf Stellen mit einem Punkt am Rand und schreibst die Stufe dazu. Die KI spart dir Zeit, die Methode braucht sie nicht.
Du gibst der KI einen Lesetext und bittest um Hilfe für B1. Zurück kommt eine Zusammenfassung mit Fragen, und im Kurs liest niemand mehr das Original. Das Material ist fertig, das Lernziel ist unterwegs verloren gegangen. Beim Hören, Schreiben und Korrigieren passiert dasselbe, nur leiser.
Dieses Kartenset setzt früher an. Jede Promptkarte sagt der KI, was sie vorbereiten darf und wo sie aufhört. Die KI übernimmt die Vorbereitung, die Lernenden behalten die Arbeit, an der sie lernen.
KI kann in Minuten alles korrigieren, und genau darin liegt das Problem. Lernwirksam wird die Auswertung erst, wenn sie weniger tut und jemand danach am Fehler arbeitet: du beim Planen mit der Satzbank, die Lernenden beim Überarbeiten mit Fähnchen oder die Leserin, für die der Text bestimmt ist. Höchstens fünf Stellen, Muster statt Einzelfehler, Ursachen als Vermutung und jede Korrektur selbst geprüft. Davor steht immer die Weiche: Echte Daten von Lernenden? Erst Namen und Persönliches raus. Sonst ohne KI. Muster statt Rotstift heißt am Ende: weniger markieren, mehr lernen lassen.